 Paweł Oleś
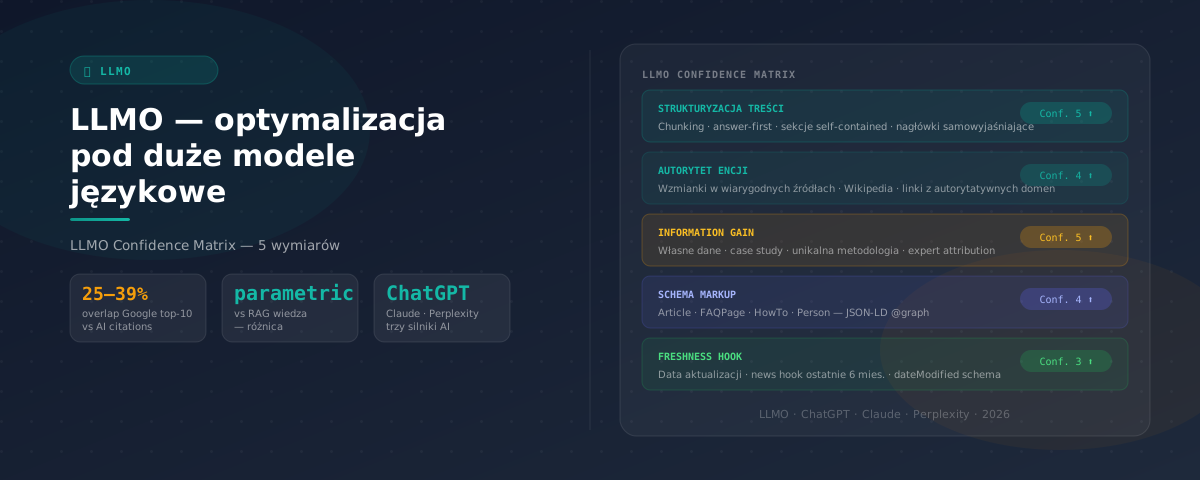
LLMO (Large Language Model Optimization) to zestaw technik optymalizacji treści i struktury strony, które zwiększają szansę na cytowanie przez duże modele językowe — ChatGPT, Perplexity, Claude, Google AI Mode. LLMO to warstwa techniczna szerzej rozumianej strategii GEO (Generative Engine Optimization): podczas gdy GEO odpowiada na pytanie co i gdzie publikować, LLMO odpowiada na pytanie jak napisać i jak ustrukturyzować treść, żeby LLM ją wybrał jako źródło.
Czym jest LLMO i czym różni się od SEO i GEO
LLMO to optymalizacja treści i struktury strony pod mechanizmy selekcji źródeł w dużych modelach językowych. Skupia się na czynnikach, które LLM ocenia przy wyborze cytatu: jasność encji, gęstość odpowiedzi, standaryzacja formatu i autorytet źródła.
| Podejście | Co optymalizuje | Cel |
|---|---|---|
| SEO | Strona w Google Search (linki, słowa kluczowe, techniczne) | Pozycja w wynikach wyszukiwania |
| GEO | Strategia contentu, PR, obecność wieloplatformowa | Widoczność marki w AI jako autorytet tematyczny |
| AEO | Odpowiedzi na pytania, schema FAQ, featured snippets | Cytowanie w voice search i AI Overviews |
| LLMO | Struktura treści, jasność encji, gęstość odpowiedzi, format | Cytowanie jako źródło w odpowiedziach LLM |
Różnica w praktyce: SEO optymalizuje stronę pod algorytm Google. LLMO optymalizuje treść pod mechanizm, który LLM używa do wyboru źródeł — trenowanie (wiedza w wagach modelu) lub RAG (Retrieval Augmented Generation, pobieranie aktualnych danych w czasie rzeczywistym). To dwa różne mechanizmy wymagające różnych podejść.
Jak duże modele językowe wybierają źródła do cytowania
Zrozumienie mechanizmu selekcji źródeł to podstawa LLMO. LLM cytuje strony przez dwa kanały — i oba wymagają innej optymalizacji.
Trenowanie a RAG — dwa różne mechanizmy
Trenowanie (parametric knowledge) to wiedza zakodowana w wagach modelu podczas uczenia. ChatGPT, Claude i inne LLM mają datę odcięcia wiedzy — treści opublikowane po tym terminie nie są w modelu. Żeby być cytowanym z wag modelu, strona musi być obecna w dużych zbiorach danych treningowych (Common Crawl, Wikipedia, arXiv, publikacje) przed treningiem kolejnej wersji modelu.
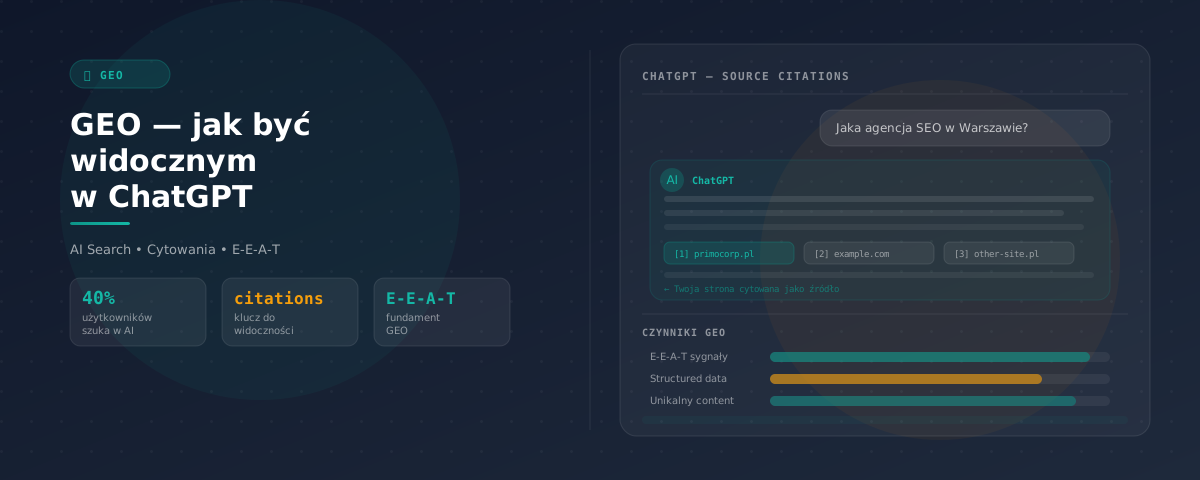
RAG (Retrieval Augmented Generation) to mechanizm, który LLM używa przy zapytaniach wymagających aktualnych danych — Perplexity i ChatGPT Search działają głównie przez RAG. Model wysyła zapytanie do wyszukiwarki, pobiera fragmenty stron w czasie rzeczywistym i generuje odpowiedź na ich podstawie. Dla RAG liczy się to, jak łatwo LLM wyodrębnia precyzyjne odpowiedzi z Twojej treści — tu LLMO ma największy, bezpośredni wpływ.
Co LLM ocenia w treści
Z obserwacji citation patterns w ChatGPT Search i Perplexity (dane SparkToro + dejan.ai, 2025–2026) wynika kilka wzorców. LLM preferuje treści, które:
- Odpowiadają bezpośrednio — pierwsze zdanie sekcji zawiera pełną odpowiedź, nie kontekst
- Definiują encje — nazwy, firmy, terminy branżowe są wyjaśnione w kontekście, nie zakładając wiedzy czytelnika
- Zawierają dane liczbowe — procenty, daty, kwoty, porównania konkretnych wartości
- Mają semantyczną jasność — brak zaimków bez antecedenta, każdy fragment rozumiany samodzielnie
- Są autorytatywne domeniowo — autor z weryfikowalną ekspertyzą, schema Person, historia publikacji w temacie
LLMO Matrix — 4 warstwy optymalizacji
Na podstawie pracy z klientami i analizy citation patterns opracowałem framework LLMO Matrix — 4 warstwy, które razem decydują o tym, czy LLM uzna stronę za wiarygodne źródło.
Warstwa 1
Entity clarity — jasność encji
Każdy termin branżowy, nazwa własna i podmiot muszą być zdefiniowane w kontekście. LLM trenuje i pobiera z treści encje, nie strony. Brak definicji = brak encji = niższy citation rate.
Warstwa 2
Answer density — gęstość odpowiedzi
Stosunek bezpośrednich odpowiedzi do ogólnego tekstu. Akapity z konkretnymi danymi, definicjami i wyjaśnieniami przyczyn mają wyższą gęstość niż akapity z kontekstem i wstępem.
Warstwa 3
Citation surface — powierzchnia cytowania
Liczba i jakość "cytowalnych fragmentów" — sekcji, które LLM może wyodrębnić i wstawić jako odpowiedź bez zmiany znaczenia. FAQ, definicje, tabele porównawcze i listy kroków to najwyższa citation surface.
Warstwa 4
Cross-platform presence — obecność wieloplatformowa
LLM ocenia autorytet encji domenowej przez jej obecność poza główną stroną: Wikipedia, LinkedIn, branżowe publikacje, cytowania przez inne autorytety. Strona bez śladu w innych źródłach jest niewidoczna dla modeli trenujących na Common Crawl.
| Warstwa | Jak mierzyć | Główna akcja |
|---|---|---|
| Entity clarity | Ile terminów branżowych ma definicję w pierwszym wystąpieniu? | Dodaj definicje w formacie "X to Y, który Z" |
| Answer density | Ile % zdań zawiera konkretną odpowiedź vs kontekst? | Przepisz wstępy sekcji na answer-first |
| Citation surface | Ile sekcji to samodzielne, cytowalne fragmenty? | Dodaj FAQ, definicje, tabele, HowTo schema |
| Cross-platform | Gdzie poza własną stroną jest wymieniana marka/autor? | PR, LinkedIn, branżowe portale, Wikipedia (jeśli dotyczy) |
Praktyczne techniki LLMO — co zmienić na stronie
LLMO nie wymaga przepisania całej strony od zera. Największy efekt dają cztery zmiany, które można wdrożyć na istniejących treściach.
1. Answer-first w każdej sekcji H2/H3. Pierwsze zdanie po nagłówku musi bezpośrednio odpowiadać na pytanie zawarte w nagłówku. Nie kontekst, nie historia, nie "wielu specjalistów uważa" — tylko odpowiedź. LLM pobiera pierwszy pasujący fragment, który odpowiada na zapytanie użytkownika.
2. Definicje encji przy pierwszym wystąpieniu. Każdy termin branżowy, skrót i nazwa własna muszą być zdefiniowane w miejscu pierwszego użycia, w formacie: "[termin] to [definicja], który/która [funkcja lub zastosowanie]". To format, który LLM najchętniej ekstraktuje jako odpowiedź na pytania "co to jest".
3. Dane liczbowe zamiast przymiotników. "Szybka realizacja" → "realizacja w 3–5 dni roboczych". "Wysoki CTR" → "CTR powyżej 5%". "Duże doświadczenie" → "ponad 150 wdrożonych kampanii". LLM cytuje dane — nie oceny. Każde zdanie z konkretną liczbą ma wyższy citation rate niż zdanie z przymiotnikiem.
4. Schema markup: FAQPage + Article + Person. FAQPage daje +40–60% citation rate w AI Search. Article z wypełnionym polem author + schema Person (z URL do profilu LinkedIn lub strony About) sygnalizuje weryfikowalną ekspertyzę. Bez tych schematów LLM traktuje treść jako anonimową.
Które AI i platformy warto uwzględnić w LLMO
W połowie 2026 roku pięć platform ma największe znaczenie dla LLMO:
- ChatGPT Search — 1 miliard zapytań tygodniowo (OpenAI, luty 2026), głównie przez RAG. Priorytetyzuje strony z wysokim autorytetem domeny i strukturą odpowiedzi answer-first.
- Perplexity — silna pozycja wśród użytkowników B2B i technicznych. Cytuje przede wszystkim treści z jasną strukturą nagłówków i danymi liczbowymi.
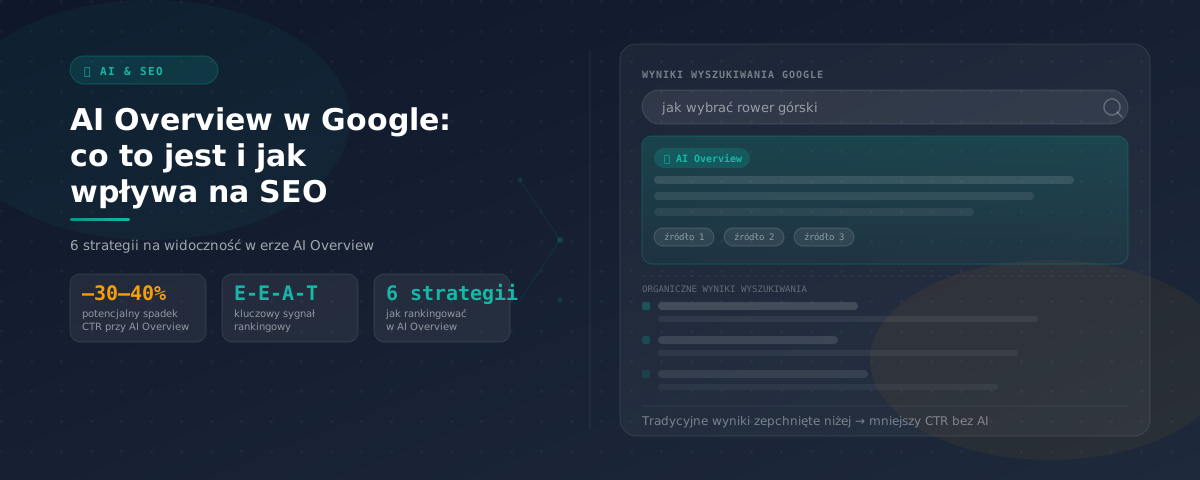
- Google AI Mode — rozszerzone AI Overviews. Premiuje strony, które już rankują w top 10 dla danego zapytania, ale cytuje je na podstawie jakości fragmentów, nie samej pozycji.
- Claude.ai — rosnąca baza użytkowników biznesowych. Wagi treningowe aktualizowane regularnie — obecność w high-authority źródłach zwiększa szansę na cytowanie.
- Microsoft Copilot — zintegrowany z Bing. Bazuje na sygnałach SEO Bing + strukturze treści. Warto monitorować szczególnie przy klientach B2B z dużą bazą użytkowników Microsoft 365.
LLMO a SEO — czy zastępuje, czy uzupełnia
LLMO nie zastępuje SEO — uzupełnia je. W 2026 roku przeważająca część ruchu organicznego nadal pochodzi z Google Search. AI Search to nowy, rosnący kanał widoczności, szczególnie ważny dla zapytań poradnikowych i definicyjnych, gdzie AI generuje odpowiedź zamiast listy linków.
Z badań SparkToro (styczeń 2026) wynika, że overlap między stronami rankującymi w top 10 Google a stronami cytowanymi przez ChatGPT dla tych samych zapytań wynosi zaledwie 25–39%. Oznacza to, że pozycja #1 w Google nie gwarantuje cytowania w AI — i odwrotnie: strony cytowane przez AI nie zawsze rankują wysoko w Google. To dwa różne kanały z częściowo różnymi sygnałami rankingowymi.
Praktyczna strategia: optymalizuj jednocześnie pod Google (SEO: linki, słowa kluczowe, techniczne) i pod AI (LLMO: answer-first, entity clarity, citation surface). Nakład pracy na LLMO jest stosunkowo niski — większość technik to modyfikacje istniejących treści, nie tworzenie nowych.
Najczęściej zadawane pytania o LLMO
Co to jest LLMO?
LLMO (Large Language Model Optimization) to zestaw technik optymalizacji treści i struktury strony, które zwiększają szansę na cytowanie przez duże modele językowe — ChatGPT, Perplexity, Claude, Google AI Mode. LLMO skupia się na jasności encji, gęstości odpowiedzi i obecności w źródłach, z których LLM trenują lub pobierają dane w czasie rzeczywistym.
Czym LLMO różni się od GEO?
GEO (Generative Engine Optimization) to szersza strategia widoczności w AI — obejmuje content, PR, budowanie autorytetu marki i obecność wieloplatformową. LLMO to techniczny layer GEO: konkretne decyzje dotyczące struktury treści (answer-first, chunking, definicje encji), które zwiększają citation rate. GEO odpowiada na pytanie "co i gdzie publikować", LLMO odpowiada na pytanie "jak napisać".
Czy LLMO zastępuje SEO?
Nie — LLMO uzupełnia SEO. W 2026 roku większość ruchu nadal pochodzi z Google Search. LLMO staje się dodatkowym kanałem widoczności, szczególnie dla zapytań poradnikowych, gdzie AI generuje odpowiedź zamiast listy linków. Overlap między stronami rankującymi w Google a cytowanymi przez AI wynosi tylko 25–39% (SparkToro, 2026) — to dwa różne, uzupełniające się kanały.
Jak sprawdzić, czy moja strona jest cytowana przez AI?
Zapytaj ChatGPT, Perplexity i Claude o frazy, na które rankujesz w Google, i sprawdź czy Twoja strona pojawia się jako źródło. Do monitorowania na bieżąco możesz użyć narzędzi takich jak Profound, Scrunch.ai, Otterly.ai lub DataForSEO AI Citation API — automatycznie śledzą cytowania i zmiany w czasie.
Od czego zacząć wdrożenie LLMO?
Zacznij od audytu gęstości odpowiedzi: sprawdź, czy pierwsze zdanie każdej sekcji H2/H3 bezpośrednio odpowiada na nagłówek. Dodaj definicje kluczowych encji branżowych w formacie "X to Y, który Z". Uzupełnij schema FAQPage i Article z Author (schema Person z URL). To minimum, które daje największy efekt w najkrótszym czasie.
Zacznij budować widoczność w AI, zanim zrobi to konkurencja
W 2026 roku większość firm w Polsce nie ma jeszcze żadnej strategii LLMO. To okno możliwości, które — podobnie jak pierwsze lata SEO — szybko się zamknie. Strony, które teraz zbudują autorytet encji i zoptymalizują treści pod citation rate, zajmą miejsce cytowanych źródeł w AI przez wiele lat.
Jeśli chcesz sprawdzić, jak wygląda Twoja strona pod kątem LLMO i gdzie są największe szanse na cytowanie — umów bezpłatną konsultację. Przejrzę konfigurację treści i pokażę, od czego zacząć.